跳到主要内容
2026 国产多模态 · 第 6 期数据截止 2026 年 10 月 18 日

2026 中国国产原生
多模态大模型对比排名
天梯榜

Qwen3.8-Max 以 95.4 分登顶,豆包 Seed 2.0 Pro 以 95.2 分紧随。0.2 分在本站方法里属于同一档——真正区分它们的不是分数,是证据等级:一个 B,一个 A。

两次扩样后榜单收到 32 款:从书生 InternVL 4.0(开源感知 96)与脑虎 NeuroXess-N1(全网唯一的神经信号模态),到海康观澜、云从从容、紫东太初、蚂蚁百灵、京东言犀、网易伏羲六款行业场景模型。评分点从 160 涨到 256,证据光谱 14A / 16B / 2C——证据等级这一列第一次有了区分度。

文档场景的第一名依然不是总榜第一,而是一款只做 OCR 的专用模型——它排第 20。这份榜单不替你决定“谁最强”。它提供可替换的权重、可复核的来源,以及一个能带进选型会的判断框架。

32参评模型
8加权维度
256评分点
14A 级证据
查看完整 24 款排名

本期头条 · LEAD ESSAY

榜首换人了;榜尾多了八款“没有第二名”的模型

8 分钟阅读 · 数据截止 2026-10-18 · 编辑部

30 秒速答

综合第一是 Qwen3.8-Max(95.4,证据 B),豆包 Seed 2.0 Pro 以 95.2(证据 A)排第二——本站把 0.5 分以内视为同一档,所以严格说这是并列第一。但两次扩样后更大的变化在榜尾:32 款里至少 15 款不出现在任何主流横评中,分布在安防、金融、电商、游戏、神经信号等十几个“没有第二名”的场景里。选型结论按场景分裂:文档批处理看 DeepSeek-OCR 2,长视频看豆包,预算敏感看 DeepSeek-V4.1-Flash,私有化看 Kimi K3,安防监控只有海康观澜,神经信号只有脑虎。

先把结论摆出来:这一期榜首换人了。Qwen3.8-Max 拿到 95.4,豆包 95.2,差 0.2 分。本站方法明确规定 0.5 分以内视为同一档,所以这不是“反超”,是并列。我们把 8 个维度权重各扰动 ±30% 跑了 2000 次:91.1% 的合理权重组合下 Qwen 在前,8.9% 的情况下豆包在前。

真正区分它们的不是分数,是确定性。Qwen3.8-Max 的证据等级是 B——厂商自报基准、发布不足 30 天、没有第三方独立复现;豆包是 A。这正是本站把能力风险和确定性风险分开报价的原因:综合分告诉你谁更强,证据等级告诉你这个“更强”在下个版本还成立的概率。要签三年期合同,用 0.2 分换 A 级证据通常是划算的。

两次扩样:从技术形态冷门到行业场景冷门

第一次扩样进的两款改善的是“技术形态覆盖”:书生 InternVL 4.0(85.0,第 16)是开源社区下载量前三、中文横评却几乎不收的感知专精模型(感知 96、MIT、A 级证据);脑虎 NeuroXess-N1(77.2,第 30)把 EEG/fNIRS 神经信号与图像、文本放进同一 token 空间,是全站唯一的 C 级证据模型,也是“神经信号解码”场景里唯一的参赛者。第二次扩样进的六款补上另一半——行业场景:海康观澜(安防监控,C 级)、云从从容(人像识别)、紫东太初(学院派全模态)、蚂蚁百灵(金融,中文 92)、京东言犀(电商商品图)、网易伏羲(游戏内容)。六款总分全部在 76–81 区间,但在各自场景里都是“没有第二名”。证据光谱随之变成 14A / 16B / 2C——证据等级这一列第一次有了区分度。

四款前沿新模型里最有业务价值的是 DeepSeek-V4.1-Flash。¥0.6/百万输出 token、文档维度 95、开源权重,在 1024px 每千张图成本曲线上是第二便宜的点(¥0.54),而排在它前面的那款(MiniCPM-V 4.5,¥0.45)综合分只有 79.6。它第一次把“便宜”和“能打”压进了同一款模型。代价同样清晰:视频 78、生成 72,不要拿它做视频问答或创意生成。

13 个月,头部模型怎么涨分

编辑部映射分,按同版权重回算历史版本;不是厂商发布时的官方跑分。

Qwen3.8-MaxDoubao 2.0 ProQwen3.5-397BGLM-5.3Kimi K3DS-V4.1-FlashInternVL 4.0
808590952025-092025-122026-032026-062026-092026-1095.495.294.692.492.387.985.0

← 左右滑动查看完整走势 →

前五名综合文档视频¥/M
通义千问 Qwen3.8-Max S+95.49793¥18
豆包 Seed 2.0 Pro S+95.29696¥15
通义千问 Qwen3.5-397B-A17B S+94.69792¥12
智谱 GLM-5.3 S92.49488¥9
Kimi K3 S92.39290¥16

文档专精模型,为什么只排第 20

DeepSeek-OCR 2 的综合分只有 81.9,排第 20,但它的文档维度是 99——全场最高,比 Qwen3.8-Max 的 97 还高两分。原因不神秘:它不支持视频、音频、生成与 Agent,模态覆盖窄,8 维加权后被“生态与覆盖”拖了下来。

这正是加权榜单的价值,也是它的陷阱。如果你的业务只有文档,就该把文档权重从 18% 提到 60%,把视频、生成、Agent 归零。这样重算,DeepSeek-OCR 2 会进入前三,而综合冠军可能掉出前五。榜单不是判决,是一组可修改的假设。对专精模型,正确的做法是直接看维度排序——总榜名次对它们的预测力接近于零。

怎么用这份榜单

  1. 先按你的主场景排序:文档、视频、Agent,三选一。
  2. 只看前三名的维度分,不要看综合分。
  3. 场景偏冷门时(工业质检、古籍竖排、神经信号、开源部署),先查对应的小天梯榜与冷门模型矩阵,再回总榜。
  4. 用选型器把部署、预算与中文要求加进去,候选通常会缩到 3–5 款。
  5. 拿 50–100 个真实样本做 PoC,记录失败率与单次成本;与榜单冲突时,以 PoC 为准。

我们刻意不做“唯一正确答案”。同一批分数,换一组权重,冠军就会换人——这一期 91.1% 对 8.9% 的扰动结果就是证据。这不是榜单不稳定,而是选型本来就应该这样。
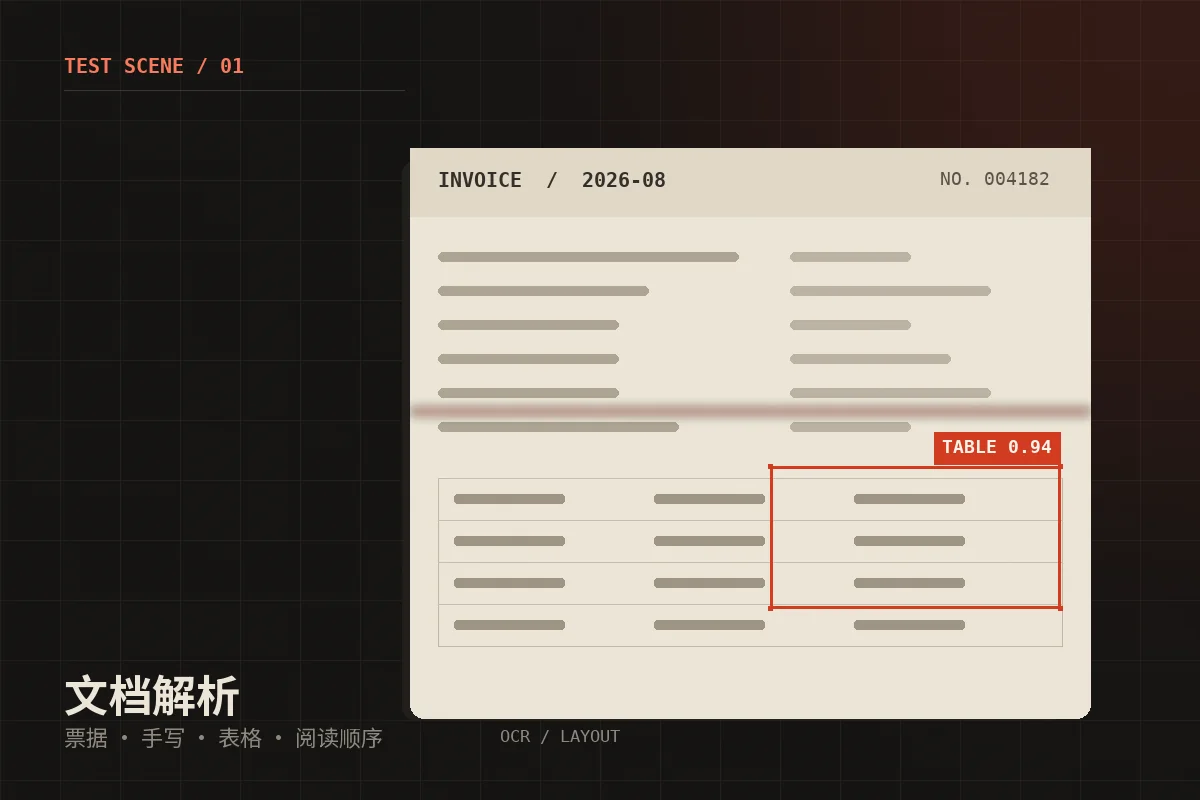
场景图集

四种难度,四组证据

每种场景都对应一组可复核的记录维度。图为评测场景示意,不是厂商界面截图。

文档:票据、手写与表格 — 2026 国产多模态模型评测场景示意文档

票据、手写与表格

同一张扫描件,分别记录字符准确率、字段对齐与阅读顺序。

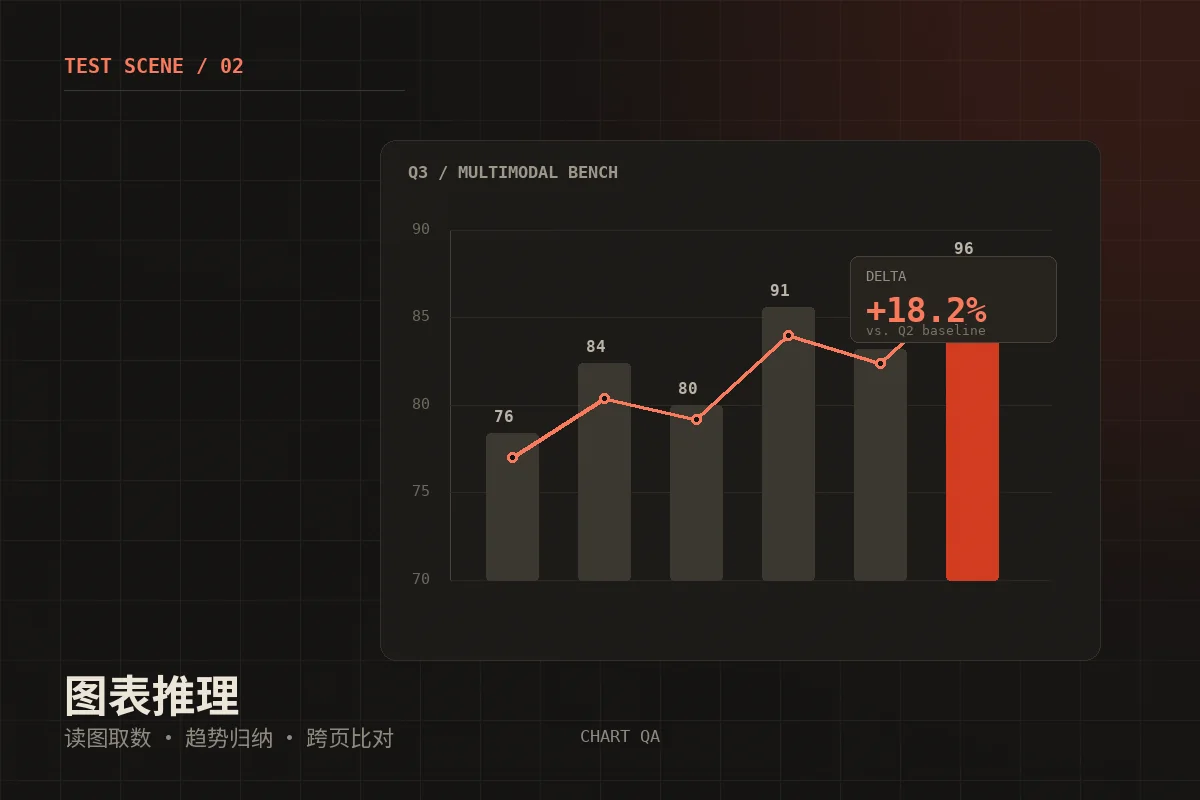
图表:从取数到结论 — 2026 国产多模态模型评测场景示意图表

从取数到结论

多系列堆叠图、跨页对比与单位换算,考的是推理而非 OCR。

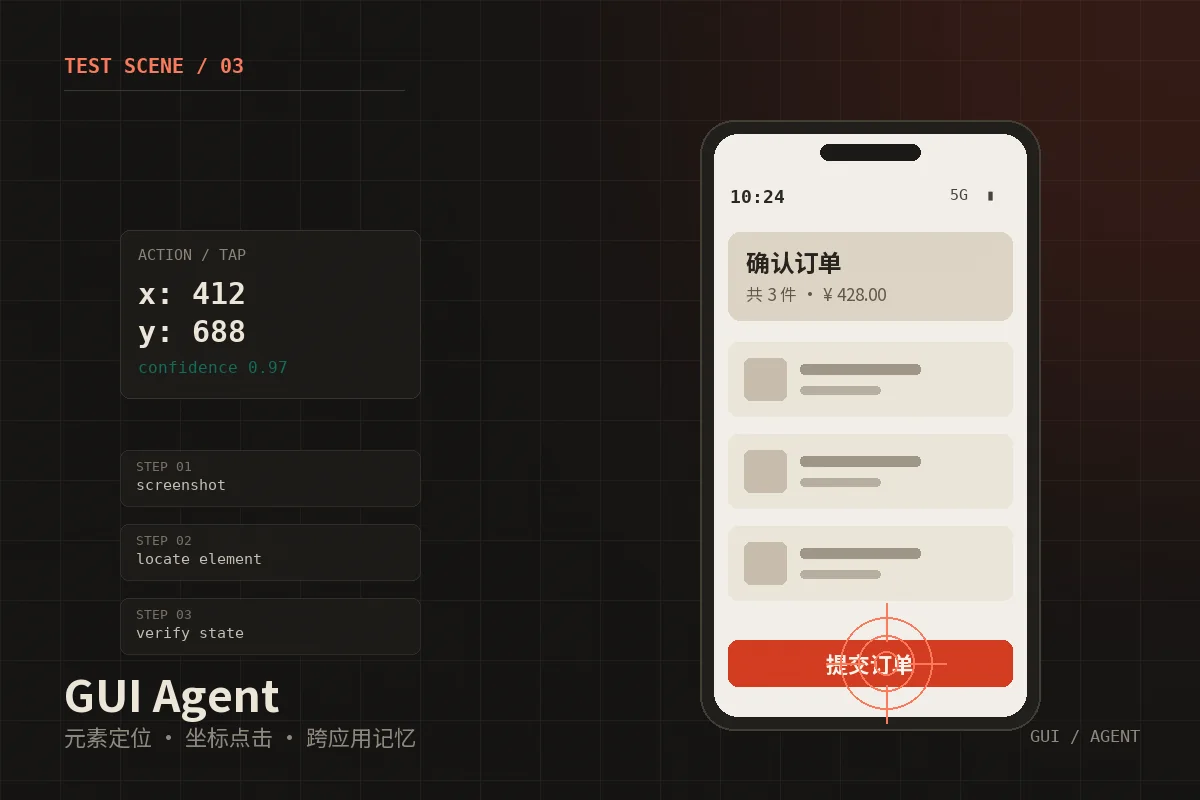
Agent:截图 → 坐标 → 动作 — 2026 国产多模态模型评测场景示意Agent

截图 → 坐标 → 动作

元素定位、点击精度、跨应用记忆与失败恢复。

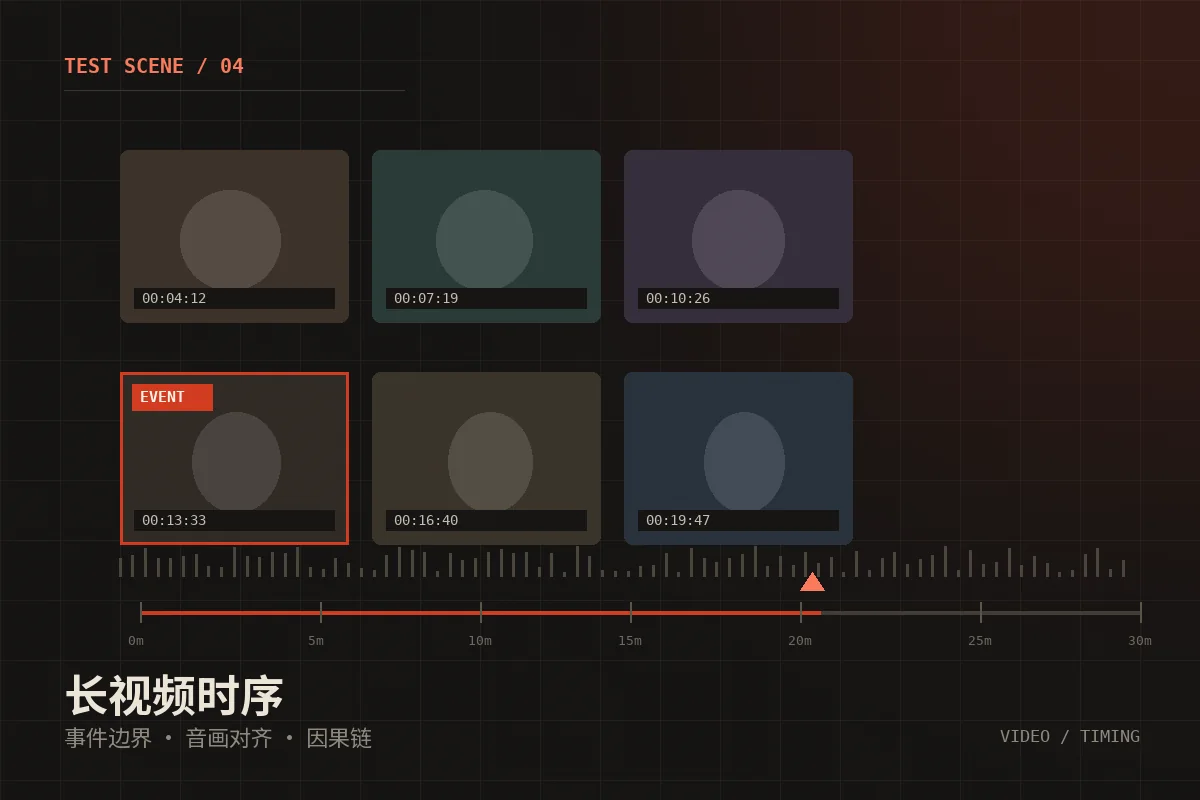
视频:事件边界与时序 — 2026 国产多模态模型评测场景示意视频

事件边界与时序

30 分钟素材里定位“谁在何时做了什么”,并解释因果。

价格 × 分数

贵的不一定强,便宜的未必弱

横轴为公开输出单价(对数),纵轴为综合分。开源模型按自托管估算价计,闭源按公开 API 价。标注四个关键点,其余可悬停查看。

算你的月度成本
高价区性价比区 ←7580859095¥0.5¥1¥2¥5¥10¥20输出价格(元 / 百万 token,对数轴)通义千问 Qwen3.8-Max · 95.4 · ¥18/MQwen3.8-Max豆包 Seed 2.0 Pro · 95.2 · ¥15/M豆包 2.0 Pro通义千问 Qwen3.5-397B-A17B · 94.6 · ¥12/MQwen3.5智谱 GLM-5.3 · 92.4 · ¥9/MGLM-5.3Kimi K3 · 92.3 · ¥16/M智谱 GLM-5 · 92.0 · ¥10/M小米 MiMo-V2.5 · 90.1 · ¥6/MMiMo-V2.5商汤 SenseNova 6.5 Pro · 89.9 · ¥12/M美团 LongCat-Next · 89.2 · ¥2.5/M通义 Qwen3-Omni-30B · 88.9 · ¥4/M文心 ERNIE 5.1 · 88.1 · ¥8/MDeepSeek-V4.1-Flash · 87.9 · ¥0.6/MDS-V4.1-Flash通义千问 Qwen3.8-Flash · 87.5 · ¥1.2/M快手 Keye-VL-2.0 · 86.0 · ¥2/M腾讯混元 Hunyuan-Vision · 85.2 · ¥8.6/M书生 InternVL 4.0 · 85.0 · ¥1/M阶跃 Step-3 · 84.7 · ¥5/M讯飞星火 X2 · 84.5 · ¥6/MMiniMax M2.5 · 83.8 · ¥8/MDeepSeek-OCR 2 · 81.9 · ¥0.8/MDeepSeek-OCR 2华为盘古 5.5 · 81.6 · ¥20/M蚂蚁集团 百灵大模型 2 · 80.8 · ¥5/M智元 硅光动语 WITA-Omni · 80.6 · ¥0/M智源 Emu3.5 · 80.5 · ¥0/M紫东太初 2.0 · 80.1 · ¥0/M面壁 MiniCPM-V 4.5 · 79.6 · ¥0.5/M海康威视 观澜大模型 3 · 78.2 · ¥0/M京东言犀大模型 2 · 78.0 · ¥6/M网易伏羲大模型 2 · 77.5 · ¥4/M脑虎 NeuroXess-N1 · 77.2 · ¥0/MBAGEL-2 · 76.9 · ¥0/M云从科技 从容大模型 2 · 76.1 · ¥7/M

← 左右滑动查看完整分布 →

01

MiMo 是性价比拐点

90.1 分、¥6/M:比旗舰低 60% 的价格拿到 95% 的综合能力。

02

文档场景不看总分

DeepSeek-OCR 2 用 ¥0.8/M 拿到文档 99 分,单页成本约为旗舰的 1/18。

03

豆包的溢价买的是稳定

贵 2.5 倍,但长任务失败率与中文长尾明显更好,适合无人值守链路。

全量热力图

一眼看完 20 × 8 的能力分布

颜色越深分数越高。表格按综合分排序,可横向滚动。表头括号内为权重。

看完整榜单
模型视觉感知20%文档 OCR18%图表推理14%视频时序14%GUI Agent14%生成编辑6%中文语境6%生态可用8%综合
通义千问 Qwen3.8-Max979796939590959695.4
豆包 Seed 2.0 Pro979694969388979895.2
通义千问 Qwen3.5-397B-A17B969795929290949894.6
智谱 GLM-5.3939491889585959792.4
Kimi K3959293909584939092.3
智谱 GLM-5939592889189959292.0
小米 MiMo-V2.5919089939086908890.1
商汤 SenseNova 6.5 Pro949390898687928289.9
美团 LongCat-Next929491878892897289.2
通义 Qwen3-Omni-30B909187908488919088.9
文心 ERNIE 5.1909289858284938888.1
DeepSeek-V4.1-Flash909592788572869587.9

展示前 12 名;完整 32 款的维度分见天梯榜页面。分数为 0–100 的编辑部映射分,不等同于任何单一公开基准。

为什么可信

分数可以不同意,方法必须公开

我们把权重、证据来源、不确定性都写在明面上。你可以复制这套表,换成自己的权重,得到属于你业务的排名。

01

权重公开

8 个维度与百分比全部列出,支持替换成你的场景权重。

02

证据分级

A 为第三方复现,B 为官方数据 + 部分复现,C 为单一来源。

03

更新可追踪

每次改动写入更新日志,旧分数保留,可回看差异。

进行中的实验一个新域名,能否靠 126 个双语页面在 Google 拿到长尾词第一?我们公开全部观察数据。

关于这份天梯榜的常见问题

2026 年国产多模态大模型哪个最强?

按本站 8 维加权评分,阿里巴巴 Qwen3.8-Max 以 95.4 分排名第一,字节跳动豆包 Seed 2.0 Pro 以 95.2 分第二,Qwen3.5-397B-A17B 94.6 第三,智谱 GLM-5.3 与 Kimi K3 分列四、五位。0.5 分以内视为同一档,所以前两名是并列第一;差别在证据等级——Qwen3.8-Max 是 B,豆包是 A。若按单一场景,文档解析第一是 DeepSeek-OCR 2,视频第一是豆包,性价比第一是 DeepSeek-V4.1-Flash。

榜单里为什么有脑机接口公司的模型(脑虎)?

因为“神经信号解码”这个场景全网只有它在测,而覆盖唯一选项正是这个榜单与普通横评的区别。它排第 25、证据等级 C(全部数字来自厂商口径)、没有公开 API——我们如实标注这三件事,由你决定是否纳入候选。同类逻辑适用于全部 15 款冷门模型:书生 InternVL 4.0(开源社区热度前三、横评缺席)、海康观澜(安防监控唯一专业选手)、蚂蚁百灵(中文 92 的金融场景模型)——通用榜上它们排在 16 名以后,在各自场景里没有第二名。

为什么榜单里有安防厂商和电商、游戏公司的模型?

因为“场景独占”和“通用能力”是两种商品。海康观澜(监控视频)、京东言犀(商品图)、网易伏羲(游戏内容)在通用榜上排在 22 名以后,但在各自场景里没有第二个满足条件的参赛者——监控数据不能公开、商品图语料独占、内容生成场景绑定,这三件事都让通用横评测不到。本站按“通用旗舰 + 专精 + 冷门 + 开源 + 行业场景”五类取样,代价是维护成本,收益是覆盖。场景→模型的完整映射见《行业场景独占地图》。

这个天梯榜和 SuperCLUE、LMArena 有什么不同?

SuperCLUE-VLM 与 LMArena 是第三方评测,本站会引用它们的公开分数,但综合分是编辑部按 8 个维度重新加权的,并额外标注证据等级 A/B/C。我们更关注“你的场景该选谁”,而不是复刻某一个榜单。

为什么 DeepSeek-OCR 2 总分只有 81.9,却被推荐做文档?

综合分按 8 个维度加权,DeepSeek-OCR 2 不支持视频、音频与 Agent,模态覆盖窄,因此总分被拉低。但在文档解析这一项它拿到 99 分,OmniDocBench v1.5 为 91.09%,且单价只有旗舰的十几分之一。选型应看维度分,而不是只看总分。

“原生多模态”与普通视觉语言模型怎么区分?

关键看三点:是否有统一的视觉 tokenizer、是否用联合目标端到端训练、是否有跨模态消融实验。仅通过适配器把图像编码器接到语言模型上,属于“拼接式”。本站为每款模型标注了原生/拼接属性。

榜单多久更新一次,数据来源是什么?

每月第一个周一更新常规数据,重大版本发布后 72 小时内补充。来源包括官方技术报告、SuperCLUE-VLM、LMArena、OpenRouter 调用数据、社区复现与厂商公开价格页,逐条列在模型页的“公开基准与数据”中。

可以引用本站的图表和结论吗?

可以。本站内容采用 CC BY 4.0 许可,转载或引用请注明“国产多模态天梯榜(2026cnmllmtierlist.com)”并链接到对应页面。商业合作与数据订正请通过关于页面的邮箱联系。